> For the complete documentation index, see [llms.txt](https://docs.nexthink.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.nexthink.com/platform/ja/user-guide/administration/ai-resources/managing-knowledge-sources.md).

# ナレッジベースの管理

Nexthink Spark および Workspace のナレッジベースを設定し、組織の内部ナレッジベース（KB）に基づいた回答を生成します。 KB 記事を CSV ファイルとしてインポートするか、ライブ外部システムに接続して、各ソースを一元的に分類・管理します。

{% hint style="info" %}
ナレッジソースの設定は **Spark** と **Workspace** で共有されます。つまり、設定されたナレッジベースソースは両方で利用可能になります。

* Spark でのナレッジソースの使用方法については、[Spark 設定とデータ入力の管理](/platform/ja/user-guide/spark/setting-up-and-managing-spark/managing-spark-settings.md#managing-knowledge-sources)を参照してください。
* Workspace でのナレッジソースの使用方法については、[Workspace を使用する](/platform/ja/user-guide/search-and-workspace/using-workspace.md)を参照してください。
  {% endhint %}

## ナレッジベースへのアクセス

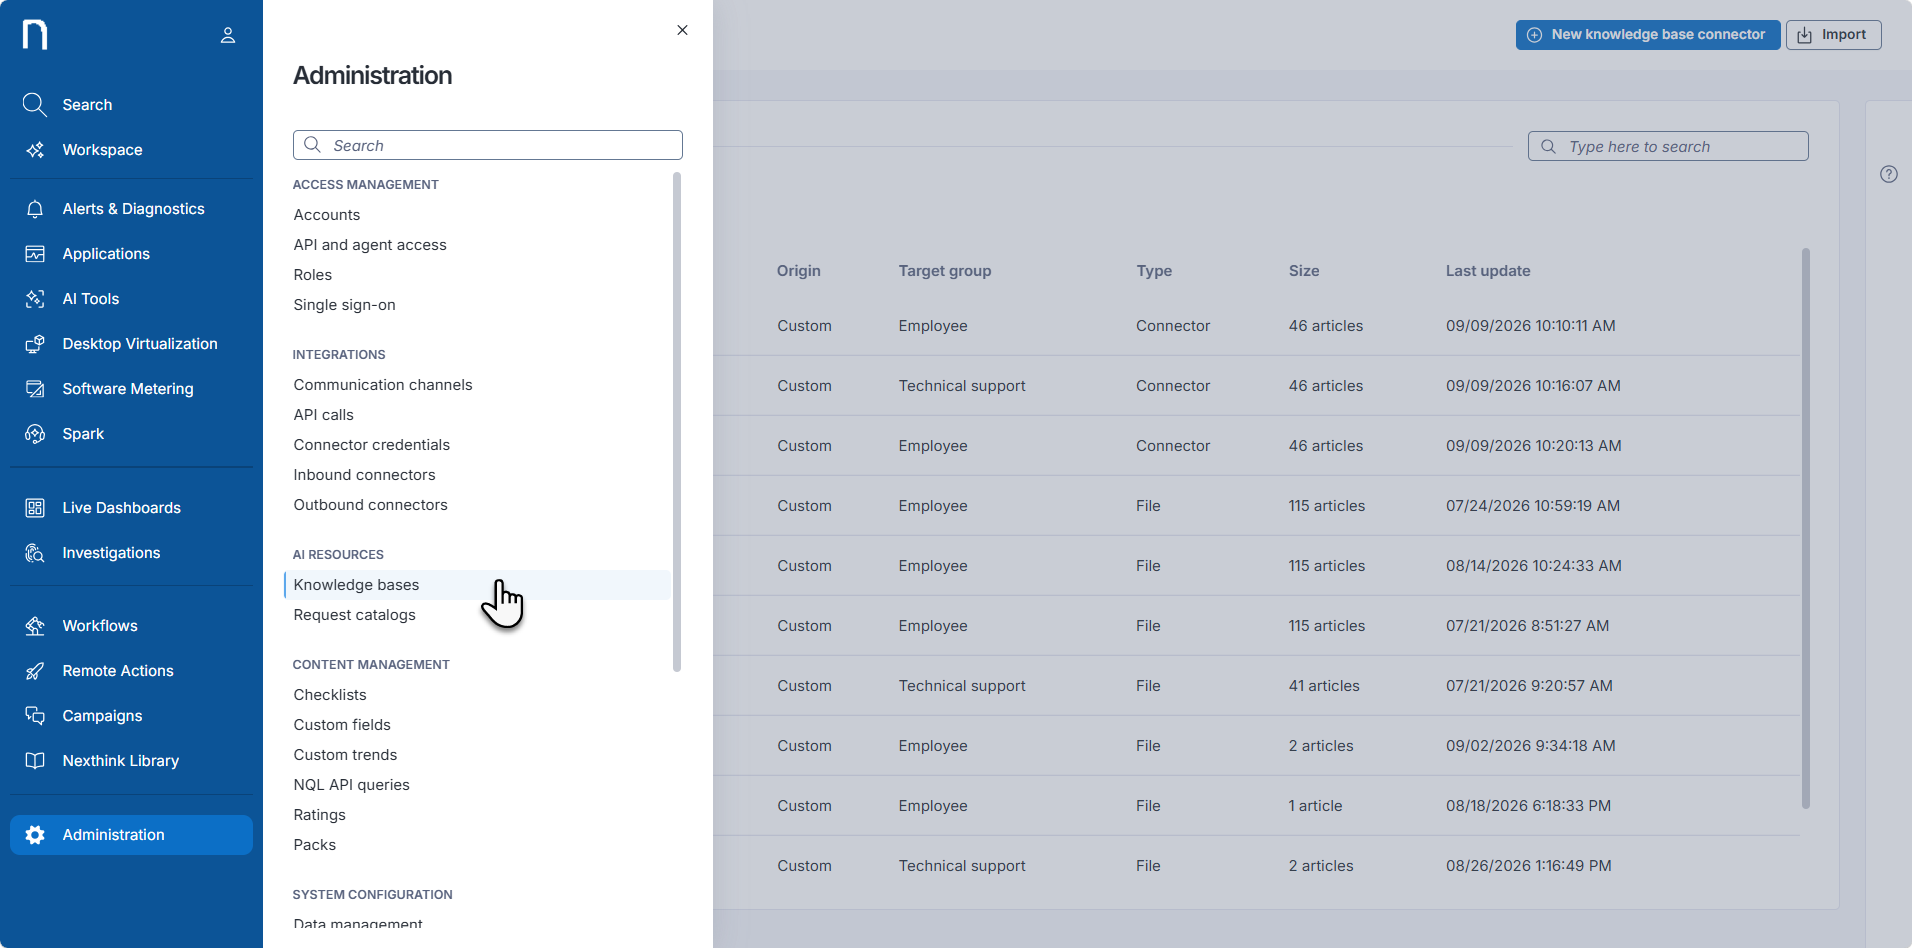
ナビゲーションパネルから **管理 > ナレッジベース** を選択します。

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-fe78fcee73e272af38f1a9238de799ed13d6520d%2Faccess_knowledge_bases_2026-09-09_11-01-53.png?alt=media" alt=""><figcaption></figcaption></figure>

## Nexthink をナレッジソースに接続する

Nexthink をナレッジソースに接続するには、次のいずれかのオプションに従います。

* **インバウンドコネクタ**を設定して、稼働中の外部システムに接続します。
* CSV ファイルから**ナレッジソースをインポート**します。

詳細については、このページで説明されている手順を参照してください。

### 稼働中の外部ナレッジソースへの接続

**ナレッジベース**ページの右上にある **新しいナレッジベースコネクタ** を使用して、ServiceNow などの稼働中の外部システムに接続します。システムは **新しいコネクタ - ServiceNow ナレッジベース**ページに移動し、そこで設定の詳細を入力できます。

必要に応じて、[インバウンドコネクタ管理ページ](/platform/ja/configuring_nexthink/bringing-data-into-your-nexthink-instance/integrating-nexthink-with-third-party-tools/inbound-connectors.md)から直接、新しいインバウンドコネクタを作成します。

コネクターの設定については、[ServiceNow Knowledge Base コネクター](/platform/ja/configuring_nexthink/bringing-data-into-your-nexthink-instance/integrating-nexthink-with-third-party-tools/inbound-connectors/connector-for-servicenow-knowledge-base.md)を参照してください。

{% hint style="info" %}
Nexthink 自体の問題をトラブルシューティングする際、システムは **Nexthink ナレッジベース**を自動的に参照します。このソースの設定は不要です。
{% endhint %}

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-46ff2748ace922d4f5d1dc95eb395ac3f2a91a17%2Fnew_KB_connector_2026-09-09_13-38-28.png?alt=media" alt=""><figcaption></figcaption></figure>

### CSV ファイルからナレッジソースをインポートする

インポートされた各 CSV ファイルは、独立したナレッジソースとして扱われ、個別に処理されます。複数のナレッジソースを共存させることができます。

以下の手順では ServiceNow を例として使用していますが、概念的には他の ITSM プラットフォームでも同様のプロセスとなります。

{% stepper %}
{% step %}

#### ITSM からエクスポートするデータを特定する

1. ITSM 内のナレッジベース記事のリストを開きます。ここでは、ServiceNow を使用します。
2. これらのフィルターを適用して、ナレッジベース記事を選択します。
   * **公開済み**の記事のみ。
   * サービスデスクのユーザーが利用できる記事。
   * 同じ記事の翻訳版を除外します。
   * インポートしたいすべての記事を含めてください。

{% hint style="warning" %}
Workspace と Spark は、ITSM の権限に関係なく、アップロードされたすべての記事にインデックスを作成します。
{% endhint %}
{% endstep %}

{% step %}

#### ITSM からデータをエクスポートする

標準の CSV エクスポートを実行して、ITSM（この場合は ServiceNow）からデータをエクスポートします：

必要なフィルターを設定した後、CSV に次の列を含めて項目リストをカスタマイズします。以下の表に記載されている、大文字と小文字を区別する列名を正確に使用してください。

{% hint style="warning" %}
ファイルが UTF‑8 でエンコードされていることを確認してください。 ServiceNow インスタンスがデフォルトで UTF-8 エクスポートを実行するように構成されていない場合は、後でファイルを UTF-8 に変換してください。
{% endhint %}

<table><thead><tr><th width="212.16668701171875">列名</th><th>説明</th></tr></thead><tbody><tr><td><code>number</code></td><td>ナレッジベース記事の識別子。<br>例: <code>KB0012345</code></td></tr><tr><td><code>short_description</code></td><td>ナレッジベース記事のタイトル。<br>例: <code>ネットワークの問題をトラブルシュートする方法</code></td></tr><tr><td><code>kb_knowledge_base</code></td><td>記事が属するナレッジベースの名前<br>例: <code>IT Knowledge</code></td></tr><tr><td><p><code>kb_category</code></p><p>(任意)</p></td><td>ナレッジベース記事のカテゴリ。<br>例: <code>Network</code></td></tr><tr><td><p><code>sys_updated_on</code></p><p>(任意)</p></td><td>最終更新日。<br>例: <code>11-06-2025</code></td></tr><tr><td><code>テキスト</code></td><td>記事コンテンツ。サポートされている形式のいずれか（プレーンテキスト、Markdown、またはHTML）で提供します。<br>例:<code>test kb</code></td></tr></tbody></table>
{% endstep %}

{% step %}

#### CSV ファイルを Nexthink にアップロードする

Nexthink で、**ナレッジベース**ページの右上からナレッジソースを**インポート**します。

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-99cdeb4c177acf85bdef923aa84ddaba427212ba%2Fimport_KB_connector_2026-09-09_13-38-28.png?alt=media" alt=""><figcaption></figcaption></figure>

<details>

<summary>ソース URL を入力する</summary>

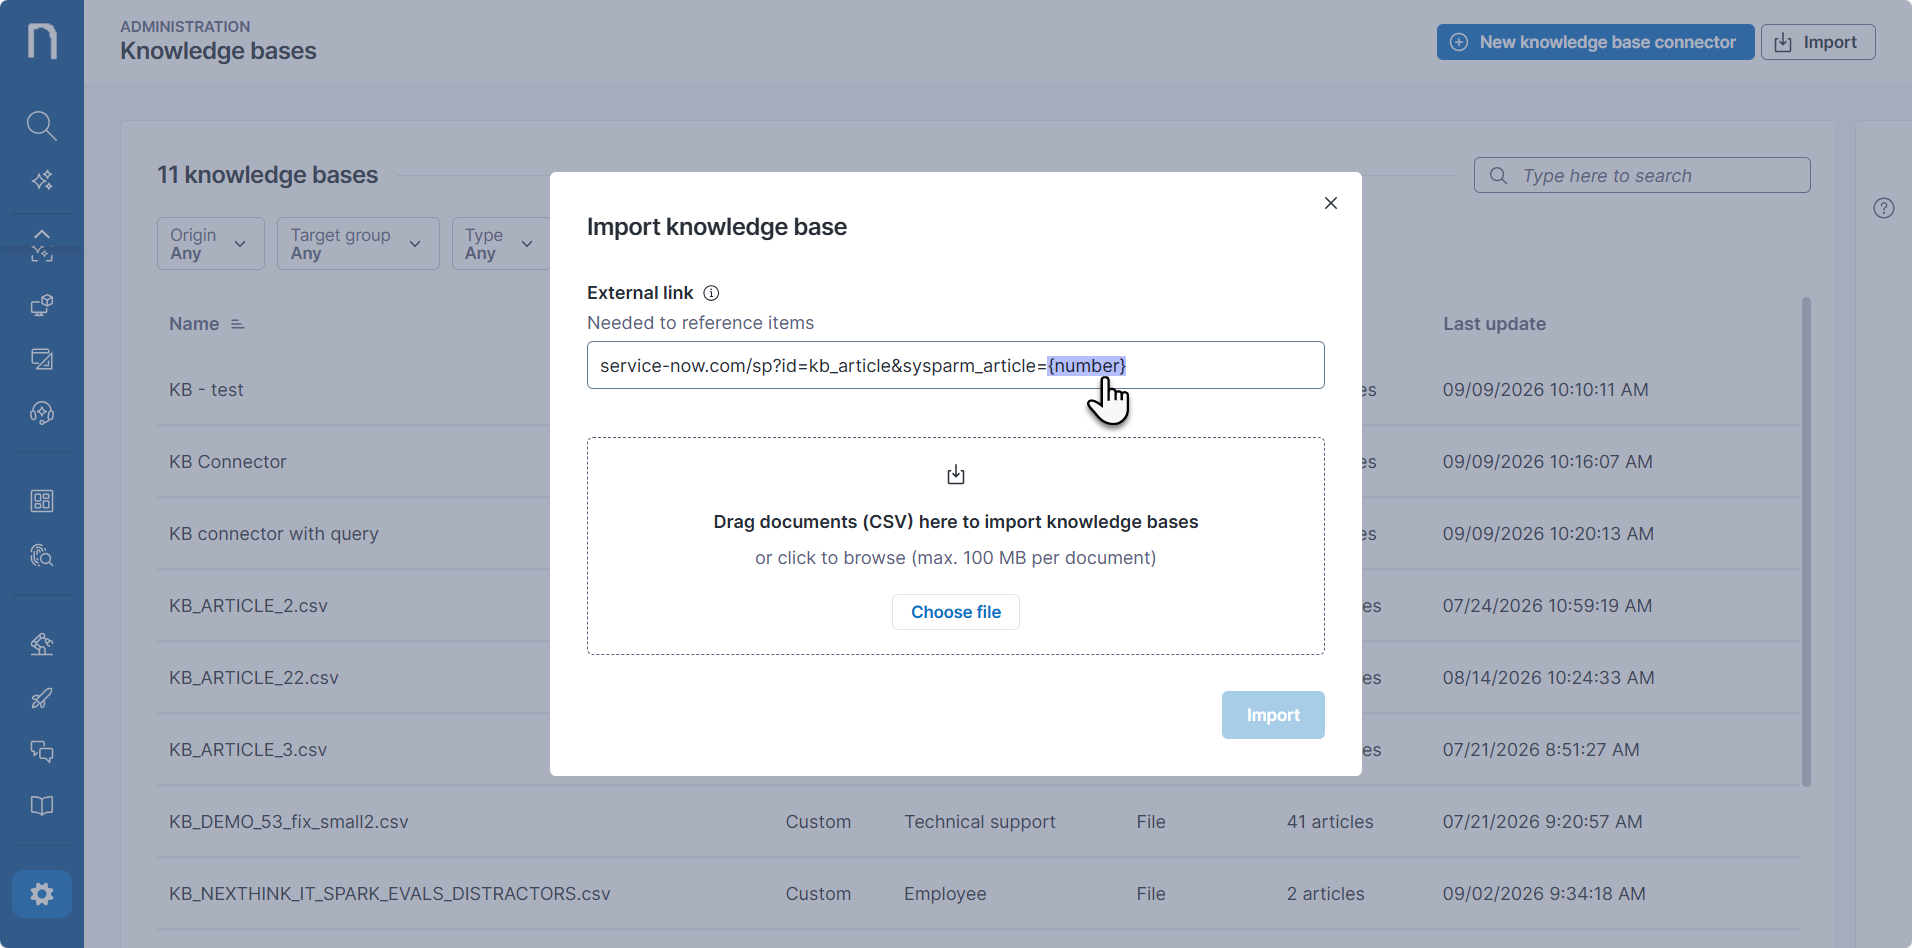
ナレッジシステム内の個々のナレッジ記事にリンクする完全なパラメーター化 URL を指定します。URL には記事識別子のプレースホルダーを含めてください。ルートのみのホスト名はサポートされていません：`https://example.company.com/path/to/item/{number}`

URL の例：

* ServiceNow：`https://<instance>.service-now.com/sp?id=kb_article&sysparm_article={number}`
* BMC Helix: `https://<instance>.onbmc.com/portal/kb/article/{number}`
* JSM: `https://<instance>.atlassian.net/servicedesk/customer/kb/view/{number}`

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-83b34ef8da308f625f893803a93be84aff7ee26f%2Fimporting_KB_2026-09-09_13-42-47.png?alt=media" alt=""><figcaption></figcaption></figure>

</details>

<details>

<summary>CSV ファイルをアップロードする</summary>

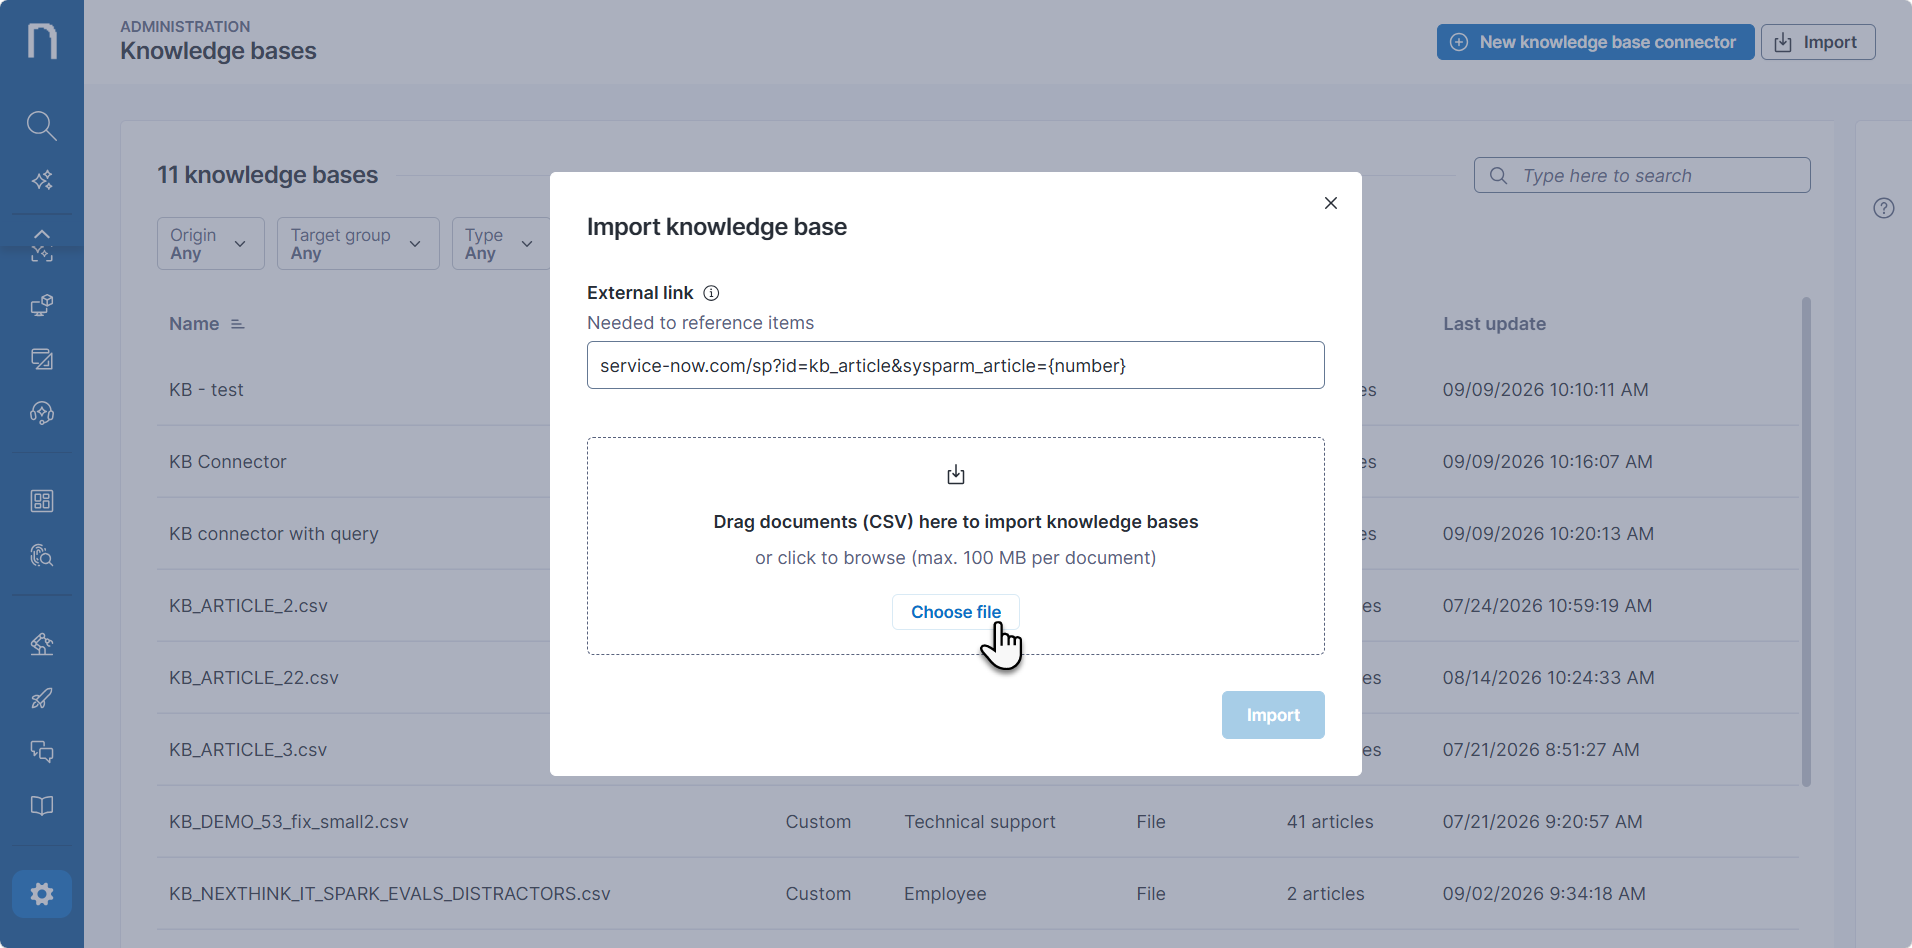
CSV ファイルをアップロード領域にドラッグ＆ドロップするか、**ファイルを選択**して参照します。ファイルあたり最大 100 MB です。ファイル内の各行は、1 件のナレッジ記事を表します。

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-07fb1c5880adecfe282f2fe6c2507d7fb57df48a%2Fupload_KB_2026-09-09_13-42-47.png?alt=media" alt=""><figcaption></figcaption></figure>

CSV ファイルを選択すると、ダイアログにファイル名とサイズが表示されます。

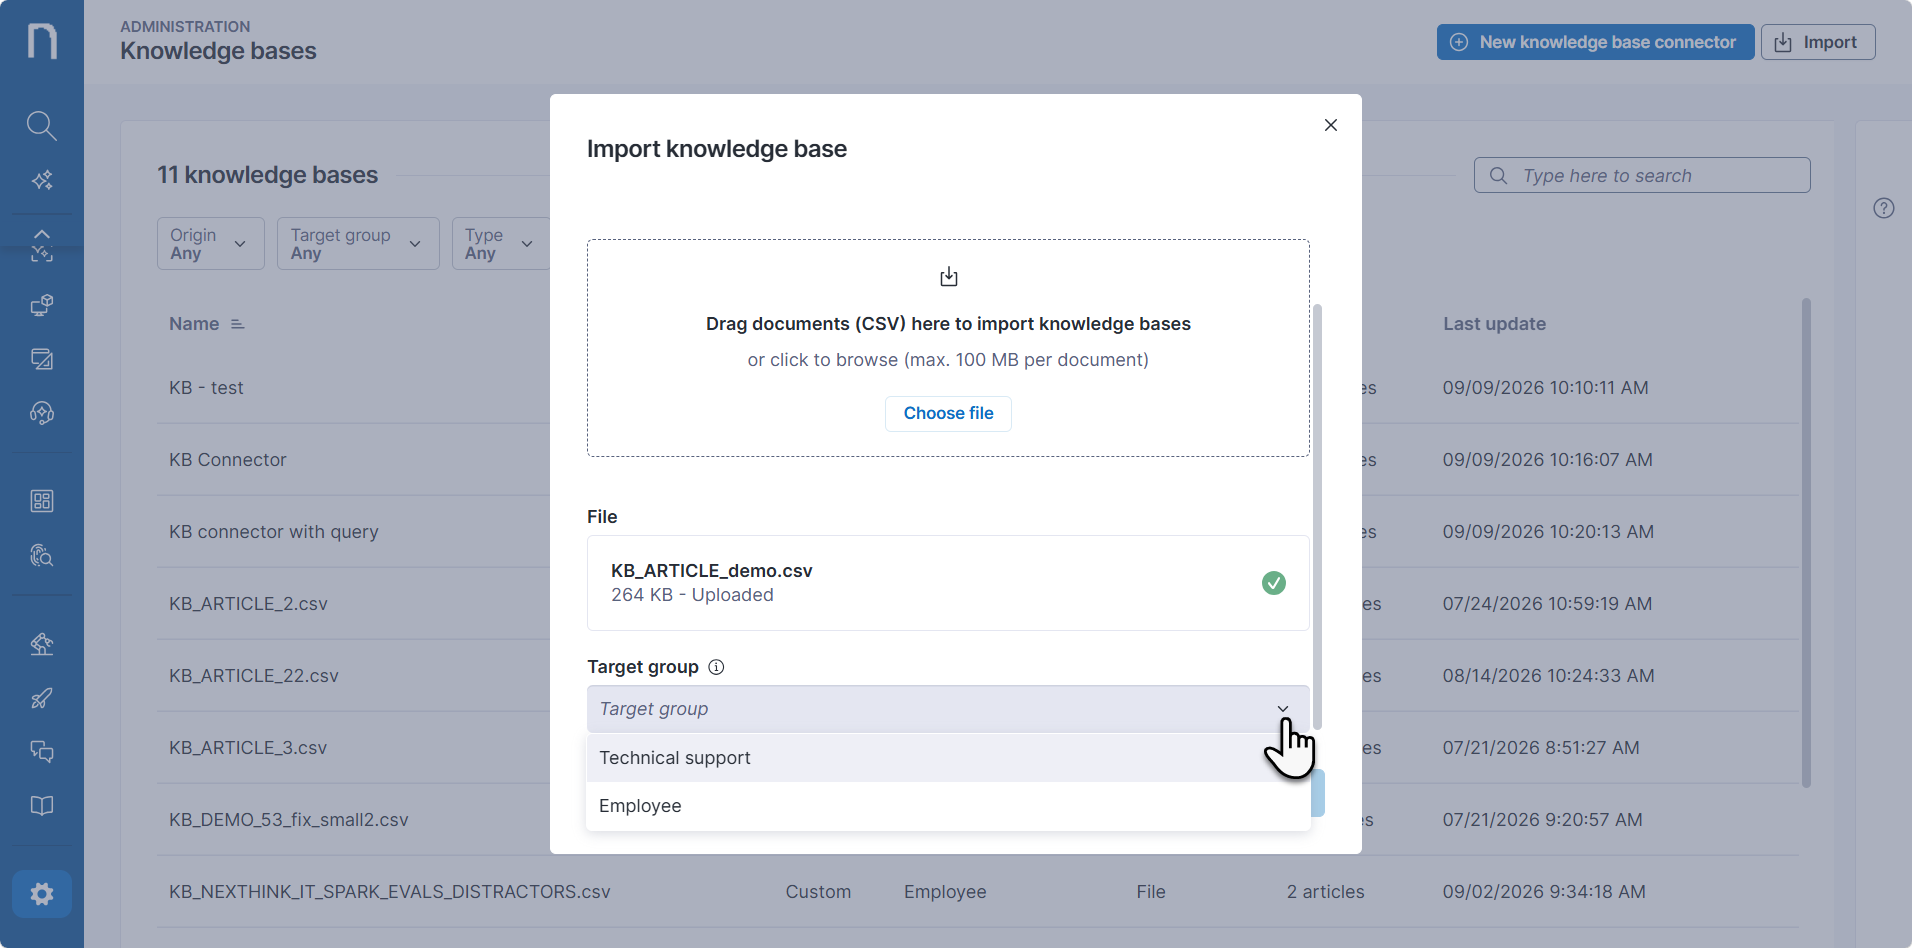
**ターゲットグループ**を定義します。

* **テクニカルサポート**：IT の問題を診断し、解決する責任を持つユーザー。
* **従業員**：日常業務のために IT サービスを利用するエンドユーザー。

インポート中にエラーが発生した場合、ダイアログに警告メッセージが表示されます。ファイルを確認してから、インポートを再試行してください。

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-cf80062619f78dbfa567af682667f94e414988a4%2FKB_target_group_2026-09-09_13-47-20.png?alt=media" alt=""><figcaption></figcaption></figure>

**インポート**をクリックして設定を完了します。

{% hint style="success" %}
インポートが成功すると、システムがファイルを検証し、確認インジケーターを表示します。
{% endhint %}

</details>

ファイルの処理は非同期で行われ、大規模なナレッジベースの場合は最大15分かかることがあります。

{% hint style="warning" %}
手動アップロードは増分ではありません。新しい CSV ファイルを Nexthink にアップロードすると、新しい内容が以前の内容に置き換わります。
{% endhint %}
{% endstep %}
{% endstepper %}

#### 手動でインポートしたナレッジソースを更新する

システムが新しいバージョンのナレッジソースファイルを処理している間も Nexthink Spark と Workspace でナレッジベースを常に利用できるようにするため、Nexthink では次の順序を推奨しています：

1. 更新されたナレッジソースファイルをアップロードし、既存のファイルはシステム内に残しておきます。
2. 新しいナレッジソースファイルの処理が完了したら、古いファイルを削除します。

{% hint style="info" %}
ナレッジベース記事の選択を改善するために、Nexthink は次のベストプラクティスを推奨します：

* 記事を常に最新の状態に保つ。
* 最適な結果を得るために、HTML の書式設定を使用してください。
* 記事本文に主要な情報を含めてください。
  {% endhint %}

***

## ナレッジソースの管理

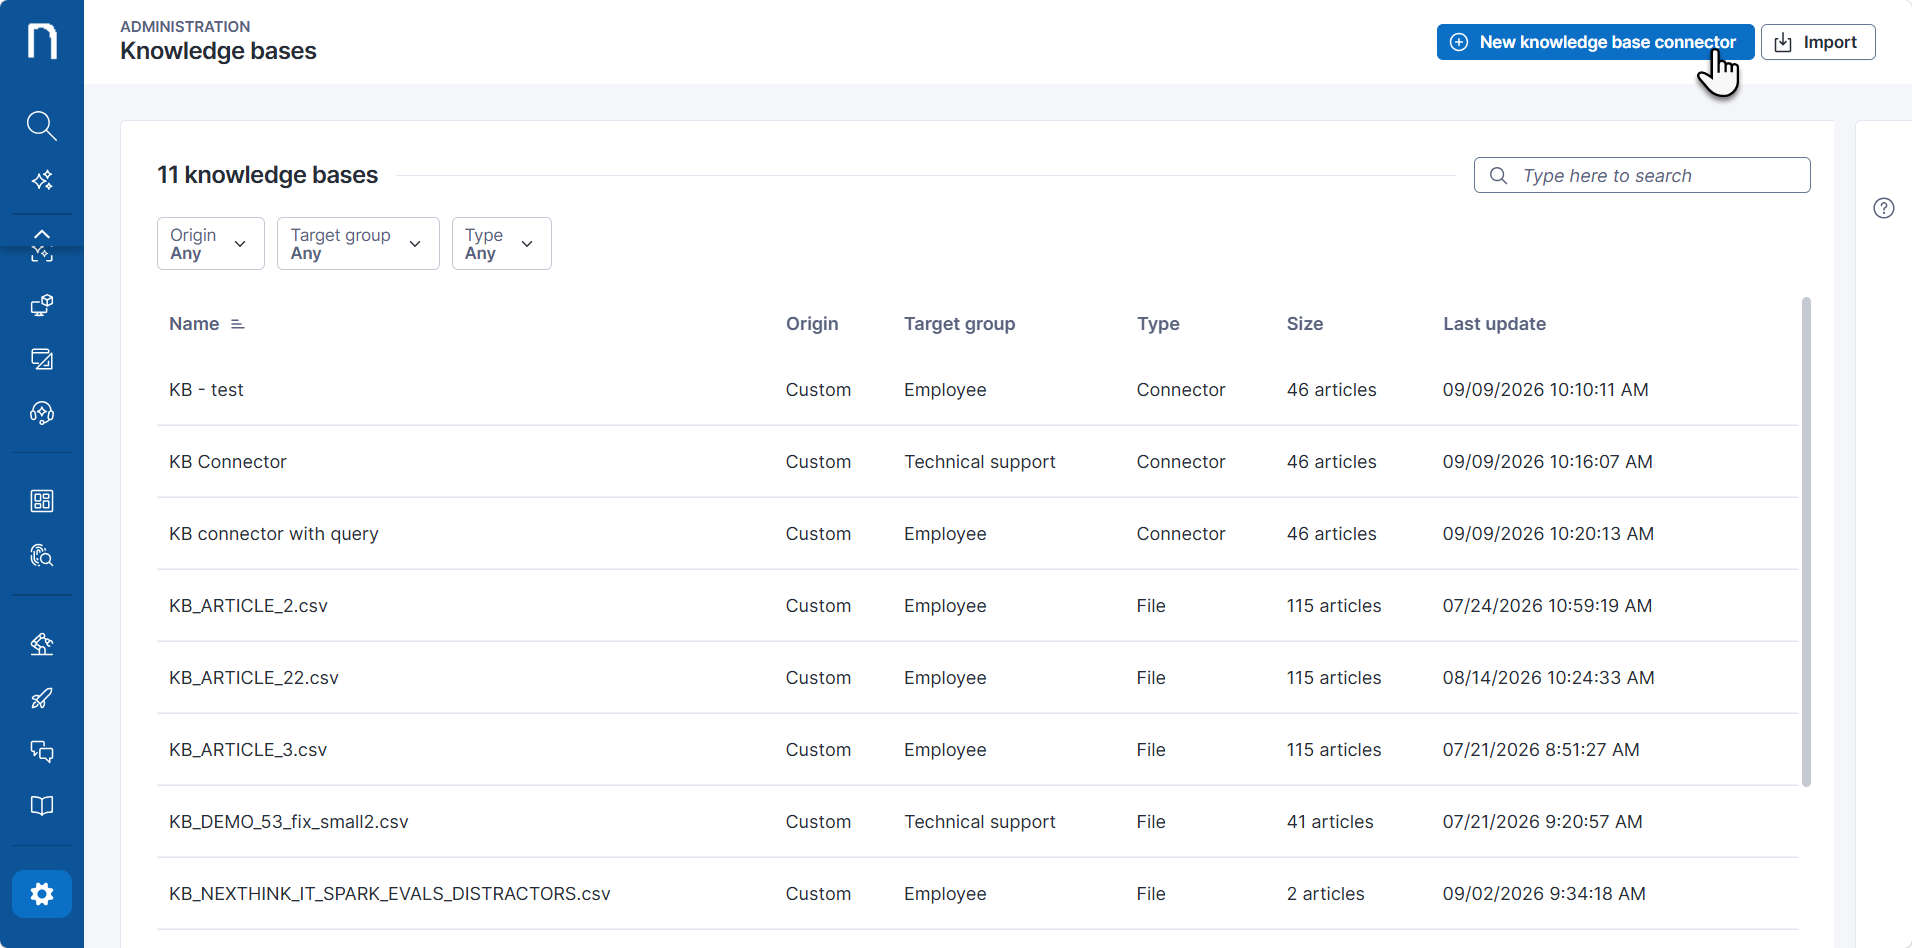
**ナレッジベース**ページには、インポートまたは接続されたすべてのナレッジソースが一覧表示されます。テーブルの各行には、次の情報が表示されます：

* \*\*名前：\*\*CSV ファイル名またはコネクター名。
* \*\*起点：\*\*ソースが追加された方法。インポートされたソースと接続されたソースはいずれも **カスタム**として表示されます。
* \*\*対象グループ：\*\*ナレッジソースの想定読者。 AI エージェントは検索およびランキングの際にこの属性を使用して、コンテキストに基づき最も関連性の高いコンテンツを表面化します。
  * **従業員**：Spark または Workspace が従業員に提示できる、エンドユーザー向けのナレッジ。
  * **テクニカルサポート**：Spark または Workspace がトラブルシューティングに使用する、IT またはサポート担当者向けのナレッジ。
* **タイプ：ソースが追加された方法に応じて、コネクターまたはファイル**。
* **サイズ**：CSV 内の項目数。システムは次のステータスも表示できます。
  * **失敗**：ファイルに構文エラーが含まれているなど、処理できない場合。この場合、エラーメッセージにカーソルを合わせると、詳細と修正案が表示されます。
  * **処理中**：ファイルに多数の項目が含まれている場合、システムが処理するのに時間がかかることがあります。
* \*\*最終更新：\*\*ソースが最後にインポートまたは同期された日時。項目が最新かどうかを評価するのに役立ちます。

<figure><img src="https://3549141153-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FeLm8O7QKZDn6z806e7Sv%2Fuploads%2Fgit-blob-acc53bc76c93496c6f15d575fc9342f8afea1a8a%2Fmanage_KB_2026-09-09_13-39-28.png?alt=media" alt=""><figcaption></figcaption></figure>

### ナレッジベースの操作

表内のナレッジベースにカーソルを合わせると、行の右側に操作メニューが表示されます。ナレッジソースのタイプに応じて、次の操作を実行できます：

* \*\*編集：\*\*既存のナレッジベースコネクタの設定を更新します。
* **エクスポート**：最後に正常にインポートされた内容に対応する元のCSVファイルをダウンロードします。各ナレッジソース CSV ファイルは、個別にのみエクスポートできます。
* **削除**：ナレッジベースを完全に削除します。
  * ナレッジベースコネクタをシステムから削除します。
  * 以前にアップロードした CSV と、関連付けられているすべてのナレッジ記事を削除します。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://docs.nexthink.com/platform/ja/user-guide/administration/ai-resources/managing-knowledge-sources.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.